如何自動從 PDF 發票抽取數據
一篇實戰指南,講解如何自動從 PDF 發票抽取乾淨數據:抽取到底是怎樣運作、為何掃描件和多供應商版式會令簡單工具失效,以及如何得出可以入帳、信得過的數字,而不用逐張人手檢查。
- 要自動從 PDF 發票抽取數據,你需要的是三層,不是一層:OCR 讀出頁面文字、欄位抽取把供應商、日期、總額和逐行明細對應成欄位,再加一層驗證去捉住前兩層出錯的地方。
- 單純的 PDF 轉 Excel 工具,只在乾淨、數碼、單一版式的發票上有效。掃描件和一堆不同供應商版式,正是準確率掉下來的地方,而大部分真實的發票堆,剛好就是這樣。
- 認真做好抽取自動化的團隊,可以把人手輸入減少 80–90%,但效益來自只把存疑的發票送給人手,而不是在全部發票上都信任機器。
- 由你單量最大的供應商開始,而不是由一個平台開始:先自動化你最常見的那一種發票版式,量度準確率,再逐步擴闊。
要自動從 PDF 發票抽取數據,你需要把每份檔案經過三層:OCR 把頁面上的字讀出來、欄位抽取把正確的數字對應到正確的欄位(供應商、發票號碼、日期、逐行明細、總額),再加一層驗證,在數據進入帳目之前先核對一次。少了第三層,你得到的只是又快又靜靜地出錯的資料輸入。這正是大多數指南略過的一環。
以下就談談,由「PDF 放進去」到「乾淨數據出來」之間到底發生甚麼事,以及如何得出無需逐張人手檢查、也信得過的數字。
自動發票抽取到底做甚麼
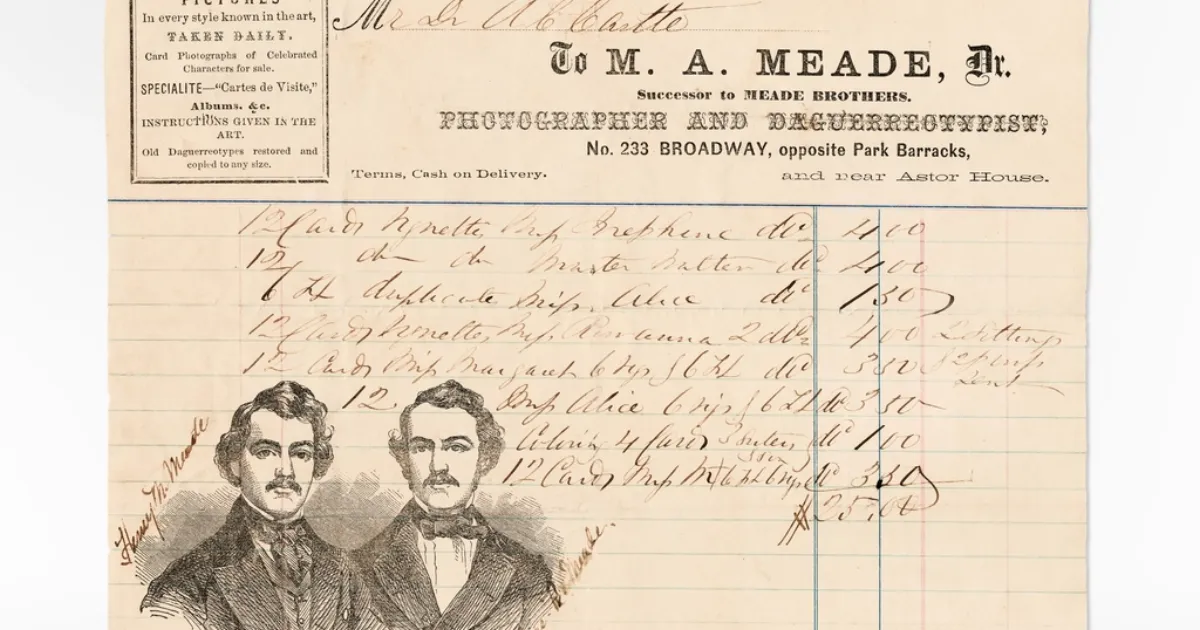
發票是一種人容易讀、電腦不容易讀的文件。自動抽取靠四步,把它變成結構化欄位:
- 擷取。 把 PDF 收進來,無論它是經電郵、上載,還是掃描器而來。
- OCR。 光學字元辨識把頁面上的文字讀出來,包括掃描件和相片,並產生一個帶有每個字位置的文字層。
- 欄位抽取。 這才是真正的工作:判斷「這個」數字是發票總額、「那個」字串是供應商,中間那一塊是帶有數量、單價和金額的逐行明細表。現代抽取會用上下文,所以能分得出發票日期和到期日。
- 匯出。 把結構化結果推進 Excel、Google Sheets、QuickBooks、Xero 或你的 ERP,準備做編碼和對數。
做得好的話,這對一個應付帳團隊可以把人手輸入減少 80–90%。但這個數字的前提,是抽取夠準、準到可以信任,而這剛好就是發票變得棘手的地方。
為甚麼單純的 PDF 轉 Excel 工具並不夠
「直接用個轉換工具」會失敗,原因是大部分發票堆並不乾淨。有兩樣東西會破壞這種簡單做法。
掃描和影相的發票。 一個靠讀取數碼 PDF 文字層的轉換工具,當「PDF」其實是一張紙本發票的相片時,就無字可讀。這時你就完全依賴 OCR 的質素,而歪斜、陰影和低解像度全都會蝕掉你的準確率。
每一家供應商的版式都不同。 一家中型公司收 200 家供應商的發票,就是在應付大約 200 種版式。總額在每張上都在不同位置。稅項有三種不同寫法。逐行明細表的欄位各異。一個逐位置複製文字的轉換工具跟不上,因為它從不學會一個欄位「代表甚麼」,只知道它在某一個範本上坐在哪裡。
所以老實的問法不是「哪個轉換工具最好」,而是「你的發票有多亂,你在 OCR 之後放甚麼去捉住它的錯」。
準確率可以有幾高?
2026 年實際的欄位級準確率,完全取決於輸入:
- 結構化發票(ERP 產生、版式一致):開箱即用 95–99%。
- 半結構化(多種供應商版式):85–95%,在最初幾星期隨訓練而改善。
- 非結構化或手寫:70–85%,存疑欄位仍然需要人手。
供應商、發票號碼和總額這類標題欄位通常做到 98–99%;棘手的是逐行明細表,最好的工具大約落在 95–97%。我們在發票 OCR 到底有幾準一文,完整拆解過這些數字在實戰中代表甚麼。
重點是,就算 95% 準確率,也代表每二十個欄位有一個是錯的。在一張有十幾個欄位的發票上,那就等於大部分文件都有一處真實的錯。單靠準確率不會令輸出可以安全入帳。驗證才會。
數碼 PDF 定掃描影像?分別很大
不是所有 PDF 都一樣,而這個分別,決定了抽取有多難。數碼 PDF(直接由供應商的會計系統匯出)自帶一個真正的文字層,數據本身已可被機器讀取,準確率因此很高。掃描或影相的 PDF,只是一張頁面的影像;底下沒有文字,於是一切取決於 OCR 有沒有把像素讀對。有個快速測試:如果你可以在檔案裡選取並複製文字,它就是數碼的;不能的話,它就是影像。大部分真實的發票收件匣,都是兩者混合,這正是為甚麼一個只處理乾淨數碼 PDF 的工具,第一天就會倒下。要為掃描件做好準備,因為它們才是製造錯誤的那些。
如何得出真正可以入帳的數字
由「抽取到」跳到「信得過」,靠的是一層夾在抽取與帳目之間的驗證。三項檢查做了大部分的工:
- 與你已有系統交叉比對。 如果發票有引用 PO,就把逐行明細和總額與它對數。兩個獨立來源一致時,信心就高;不一致時,你就找到了那條需要人手的行。
- 業務規則。 總額必須等於逐行明細加總。稅項必須落在預期範圍。日期不可能早過 PO。大多數抽取錯誤一出現就違反了其中一條規則。
- 信心評分。 每張發票都有一個分數。高信心的直接入帳;低信心的送去覆核。
那個信心步驟就是整場遊戲的關鍵。這與我們在對數自動化要做到 97% 準確率,關鍵在哪所講的空運提單對數,是同一個原則:系統知道自己甚麼時候沒把握,並只把那些升級處理。你追求的不是一部永不出錯的機器,而是改變那個比例,讓一個覆核者處理那 10–20% 真正存疑的發票,而不是把 100% 的發票重新輸入。
如何在不買平台的情況下開始
你不需要一個六位數的平台去試這件事。由窄處開始:
- 選你單量最大的供應商。 先自動化你最常見的那一種發票版式。它最容易做準,回報也最即時。
- 在你自己的文件上量度真實準確率, 而不是看供應商的示範。追蹤有幾多張發票在無人碰過下就入了帳。
- 一次擴一種版式, 邊做邊加驗證規則,慢慢摸清錯誤藏在哪。
如果你想在投入前先估算回本,我們的文件自動化 ROI 計算器可以把你的發票單量和輸入時間,換算成一個以小時和成本計的估算。而如果你寧願我們直接看你真實的發票流程、老實告訴你哪裡值得自動化、哪裡不值得,那正是免費的 30 分鐘 ROI 診斷要做的事。
抽取只是這個問題最容易的 8 成。你在它背後建起來的那層驗證,才決定這些數字值不值得信。
常見問題
- 直接把 PDF 發票轉成 Excel 夠不夠?
- 對於一張乾淨、數碼、單一供應商的發票,轉換工具可以行得通。但一遇上掃描或影相的發票、或者多種供應商版式,它就會失效,因為它是逐個位置複製文字,而不是理解哪個數字是總額、哪個是逐行明細。這正是為甚麼大部分應付帳團隊需要的是抽取加驗證,而不是一個轉換工具。
- 自動發票數據抽取有幾準?
- 視乎輸入。結構化、由 ERP 產生的發票可達 95–99% 欄位準確率;不同供應商版式大約 85–95%;掃描或手寫發票則接近 70–85%。真正重要的不是模型的準確率,而是有幾多張發票可以在無需人手檢查下入帳。
- 一張發票可以抽取到甚麼數據?
- 標題欄位,例如供應商名稱、發票號碼、日期、PO 號碼、稅項和總額,再加上逐行明細表(描述、數量、單價、金額)。做得好的系統會把逐行明細與標題連在一起,讓總額可以與明細加總互相核對。
- 你是否仍然需要人手參與?
- 是,針對存疑的個案。目標不是完全不要人,而是讓系統把它有信心的發票入帳、只把低信心的送給人手,這樣一個覆核者處理例外,而不是逐張輸入。